Năng lực mô hình
So sánh mô hình theo tám chiều, từ trí tuệ đến chi phí sử dụng và khả năng phản hồi.
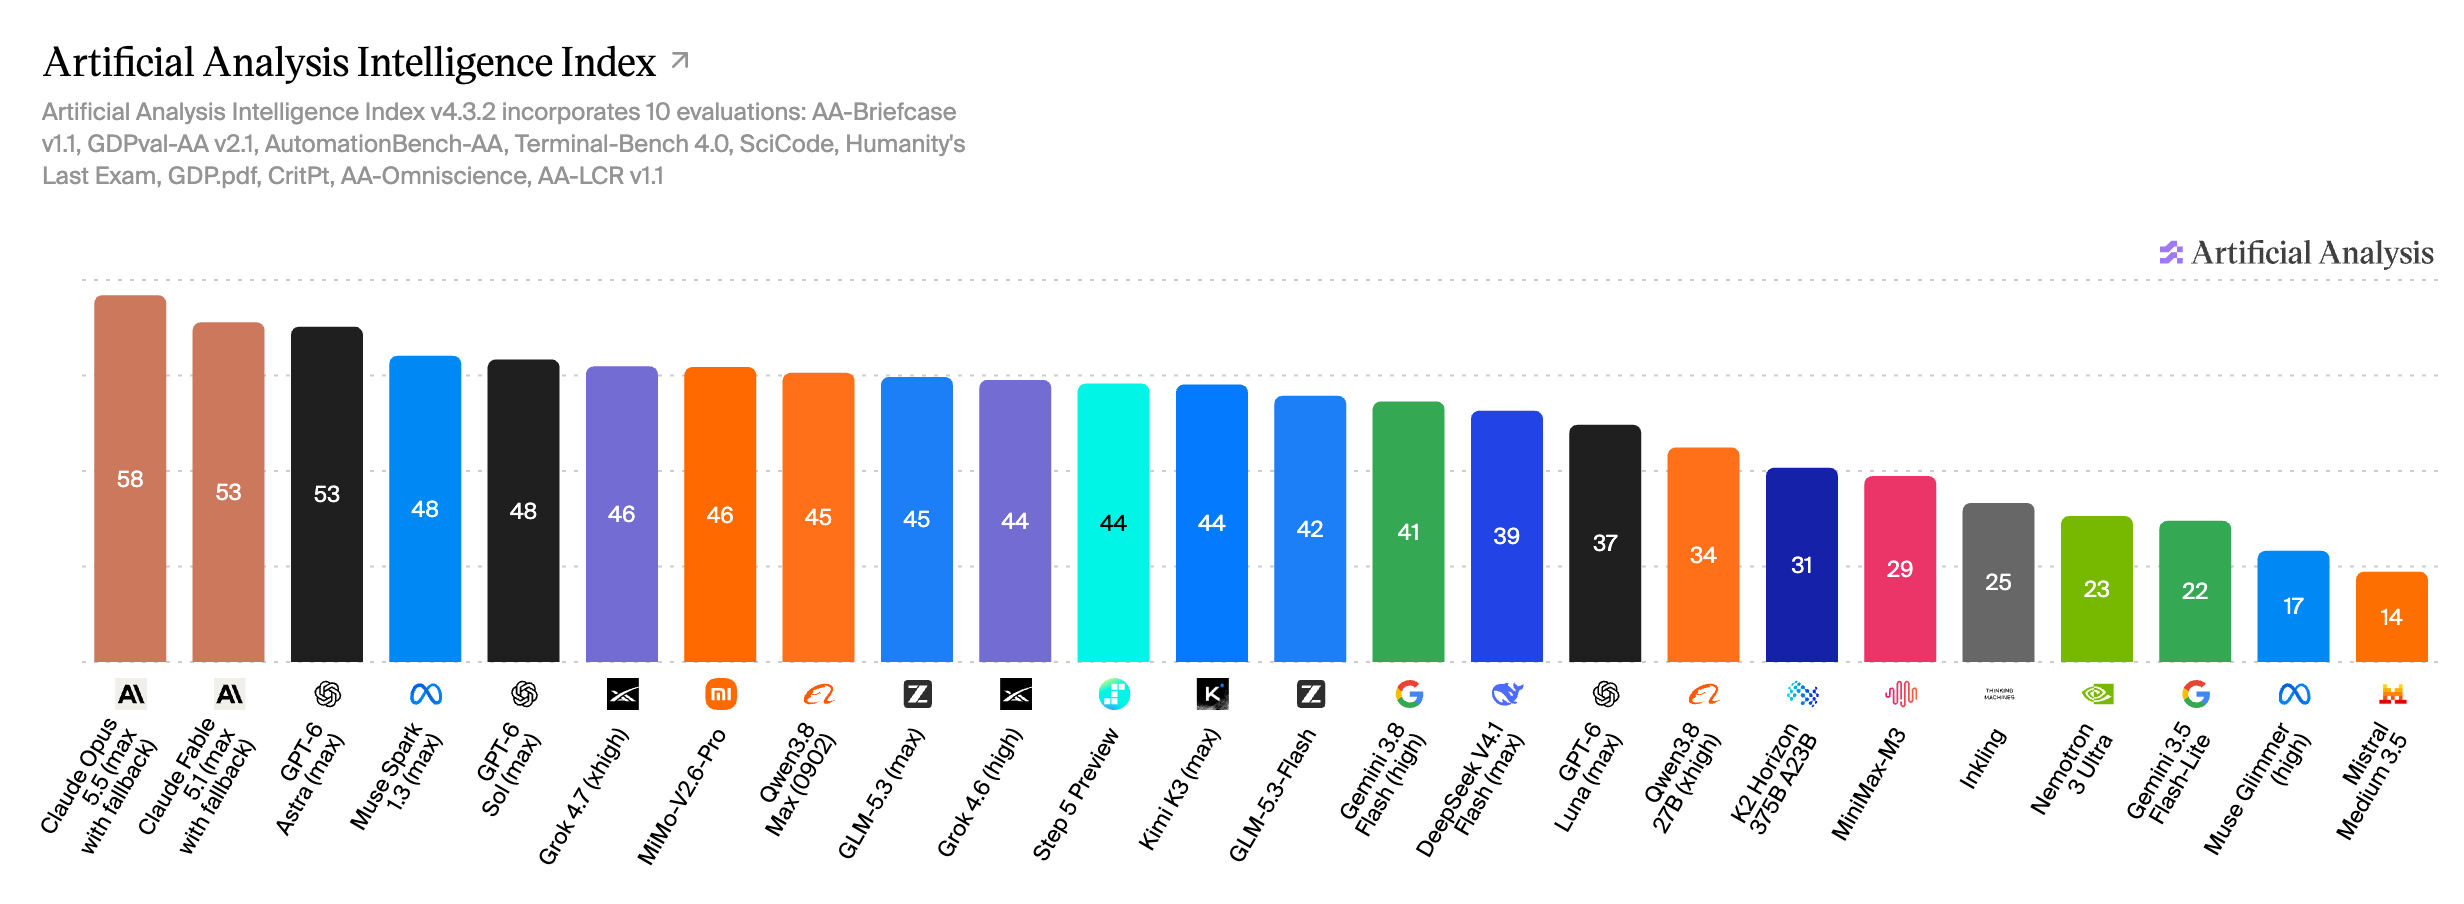
Trí tuệ tổng thể
So sánh năng lực tổng thể về suy luận, lập trình và công việc tri thức.
Diễn giải biểu đồ
Trong nhóm này, Opus 5.5 dẫn đầu với 58; Fable 5.1 và GPT-6 Astra cùng làm tròn thành 53. Cần giữ nguyên thiết lập suy luận khi so sánh.
Đánh giá chuyên biệt
Xem riêng lập trình, suy luận, kiến thức thực tế, ngữ cảnh dài và suy luận hình ảnh.
Mở 19 biểu đồ đánh giá19 bài đánh giá · thang đo riêng
Diễn giải biểu đồ
Mô hình dẫn đầu thay đổi theo tác vụ: xem Terminal-Bench và SciCode cho lập trình, AA-LCR cho ngữ cảnh dài, MMMU-Pro cho suy luận hình ảnh.
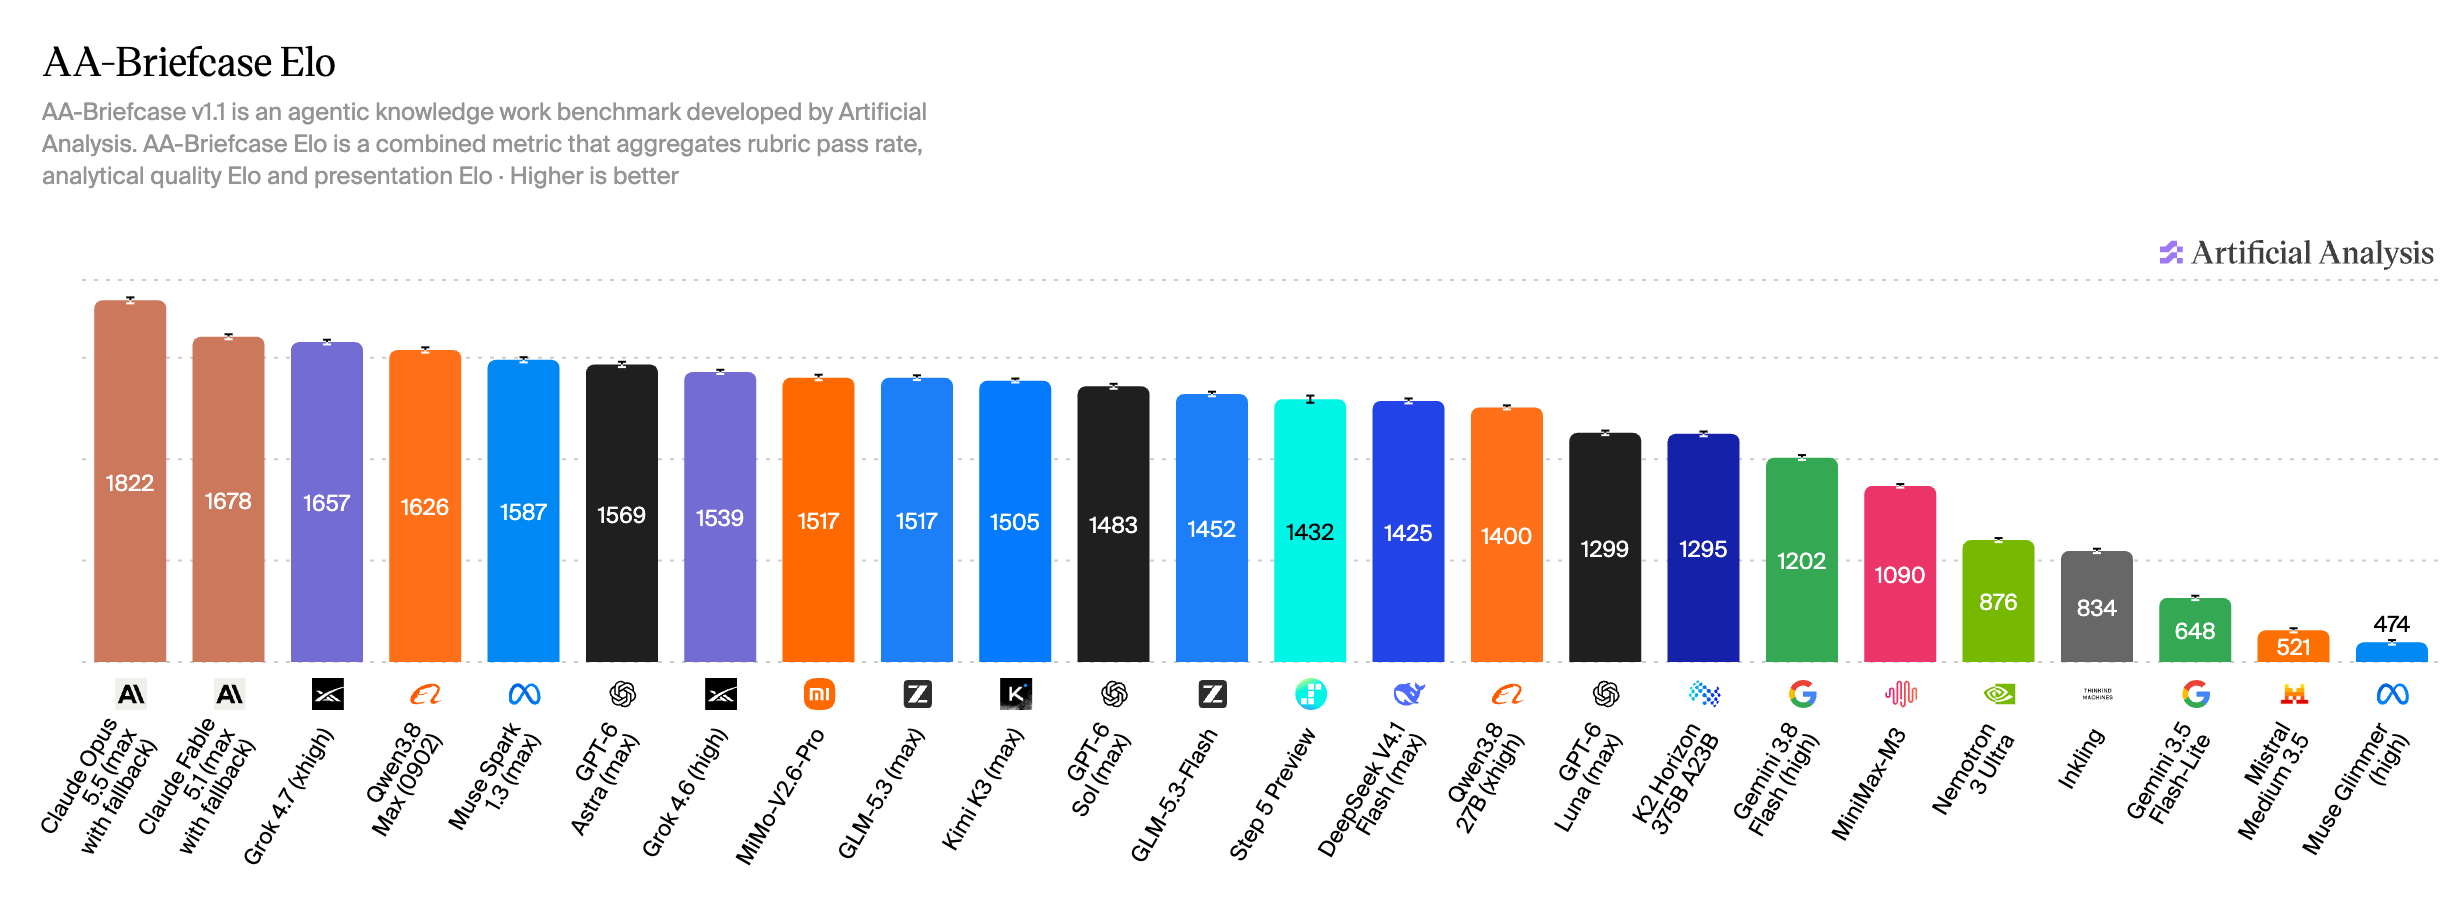
Agent xử lý công việc tri thức
Đánh giá khả năng agent biến yêu cầu phức tạp thành sản phẩm hữu ích.
Diễn giải biểu đồ
Trong nhóm này, Opus 5.5 đạt 1822 Elo, tiếp theo là Fable 5.1 với 1678 và Grok 4.7 với 1657.
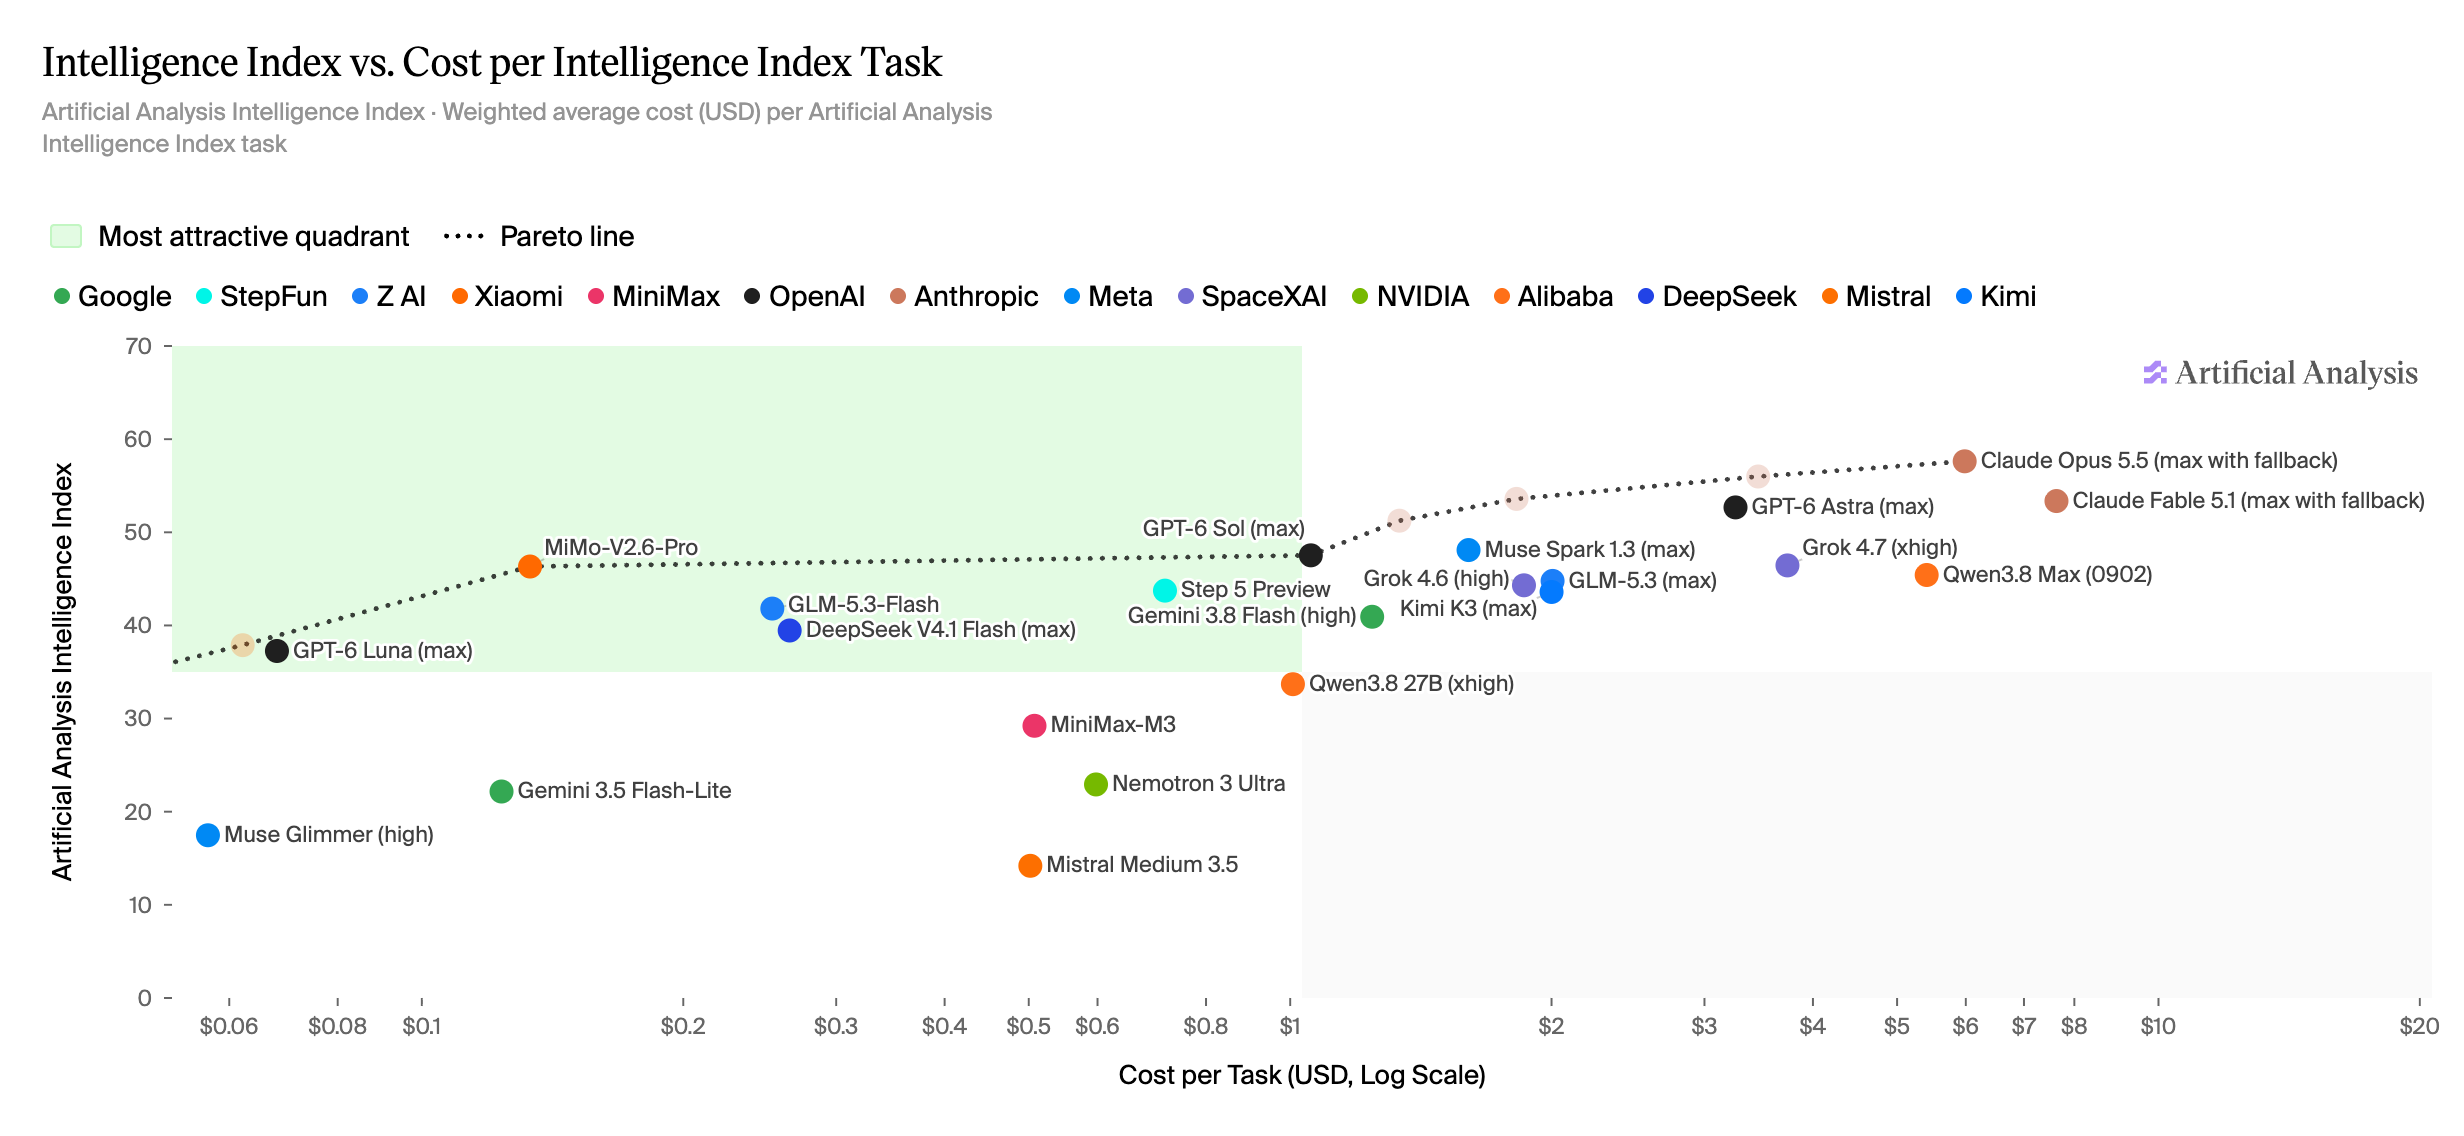
Năng lực và chi phí
Tìm năng lực cần thiết với chi phí mỗi tác vụ hợp lý.
Diễn giải biểu đồ
Vùng trên bên trái kết hợp năng lực cao và chi phí thấp. Đường biên chấm giúp nhận diện lựa chọn hiệu quả trong nhóm mô hình.
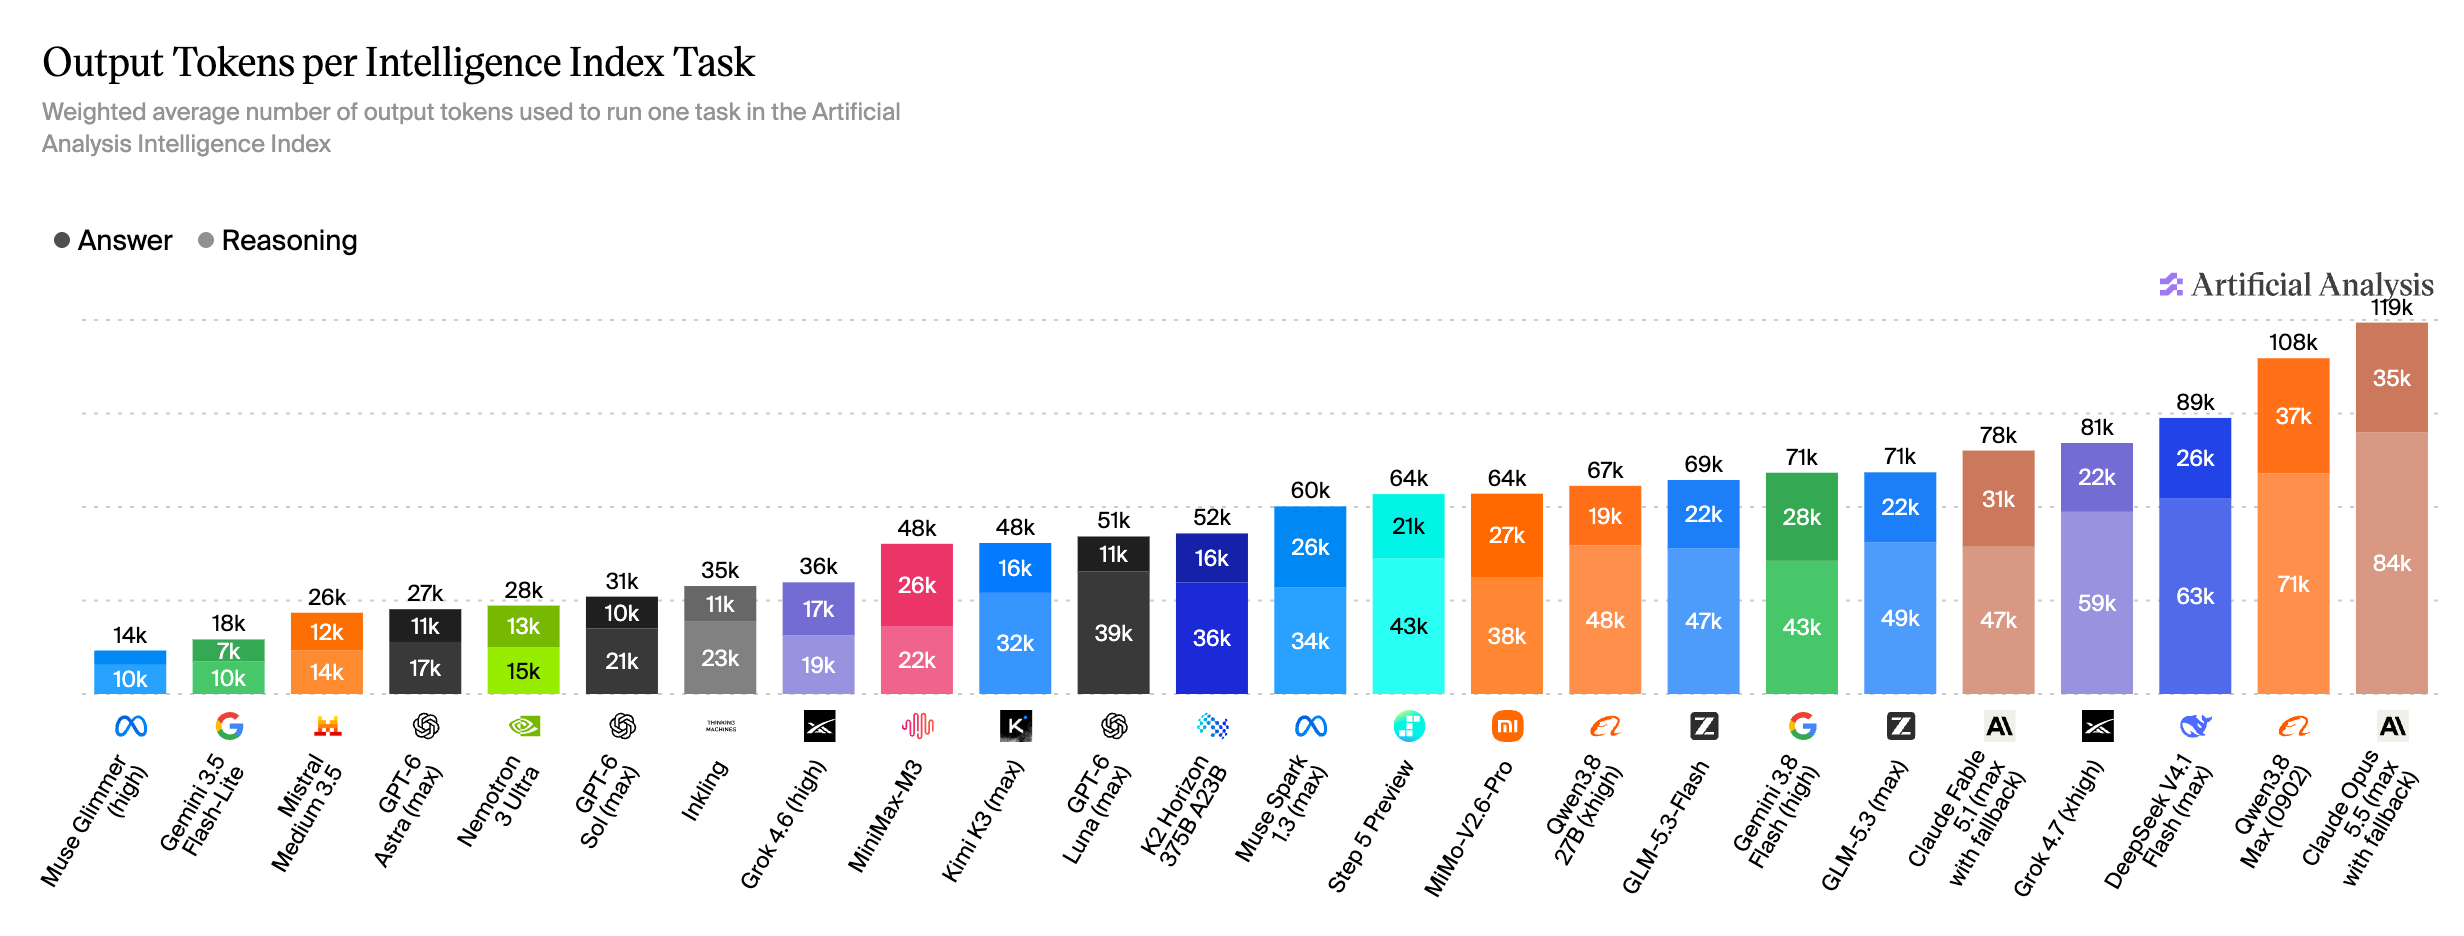
Hiệu quả token
Xem lượng token suy luận và trả lời tiêu thụ cho mỗi tác vụ đánh giá.
Diễn giải biểu đồ
Opus 5.5 dùng khoảng 119k token đầu ra mỗi tác vụ, so với 31k của GPT-6 Sol. Token suy luận chiếm tỷ trọng lớn.
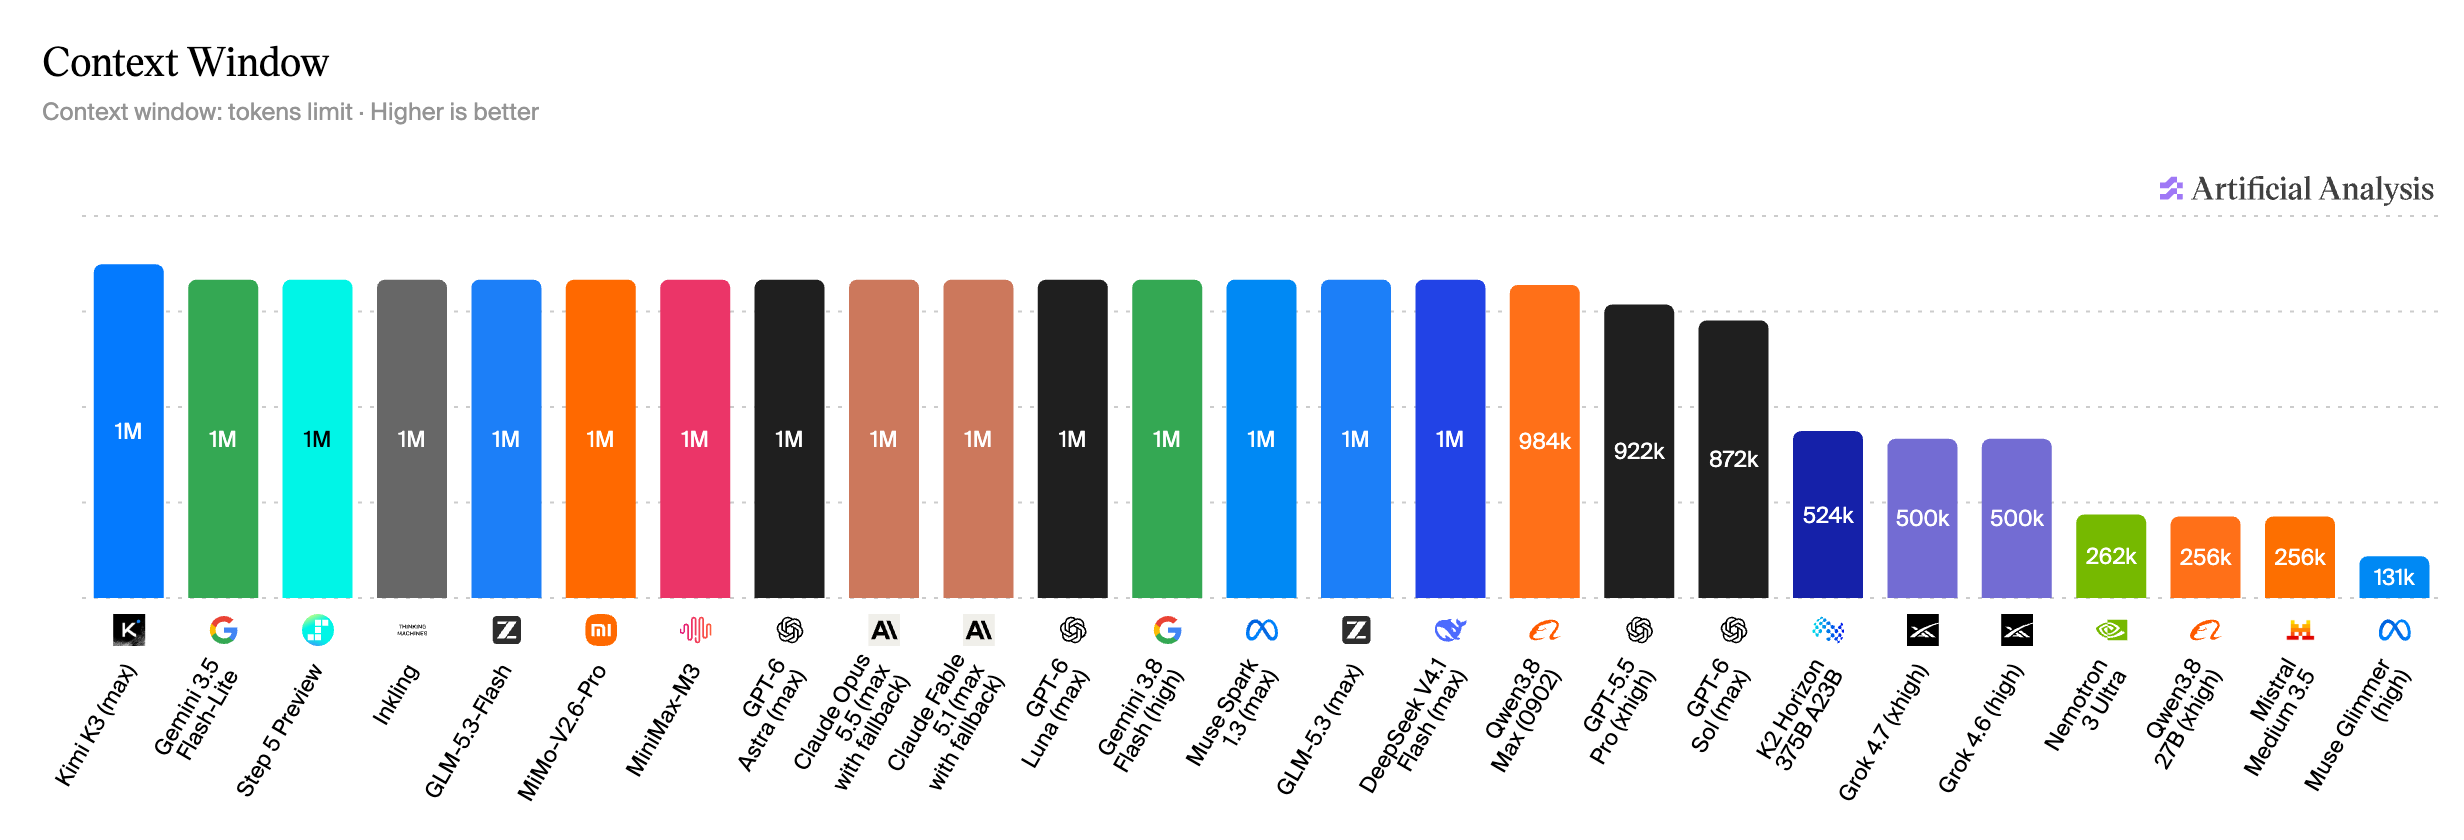
Dung lượng ngữ cảnh
So sánh dung lượng dành cho tài liệu, mã nguồn và lịch sử hội thoại.
Diễn giải biểu đồ
Nhiều mô hình trong nhóm có ngữ cảnh khoảng 1M token; Grok 4.7 hiển thị 500k và Mistral Medium 3.5 là 256k.
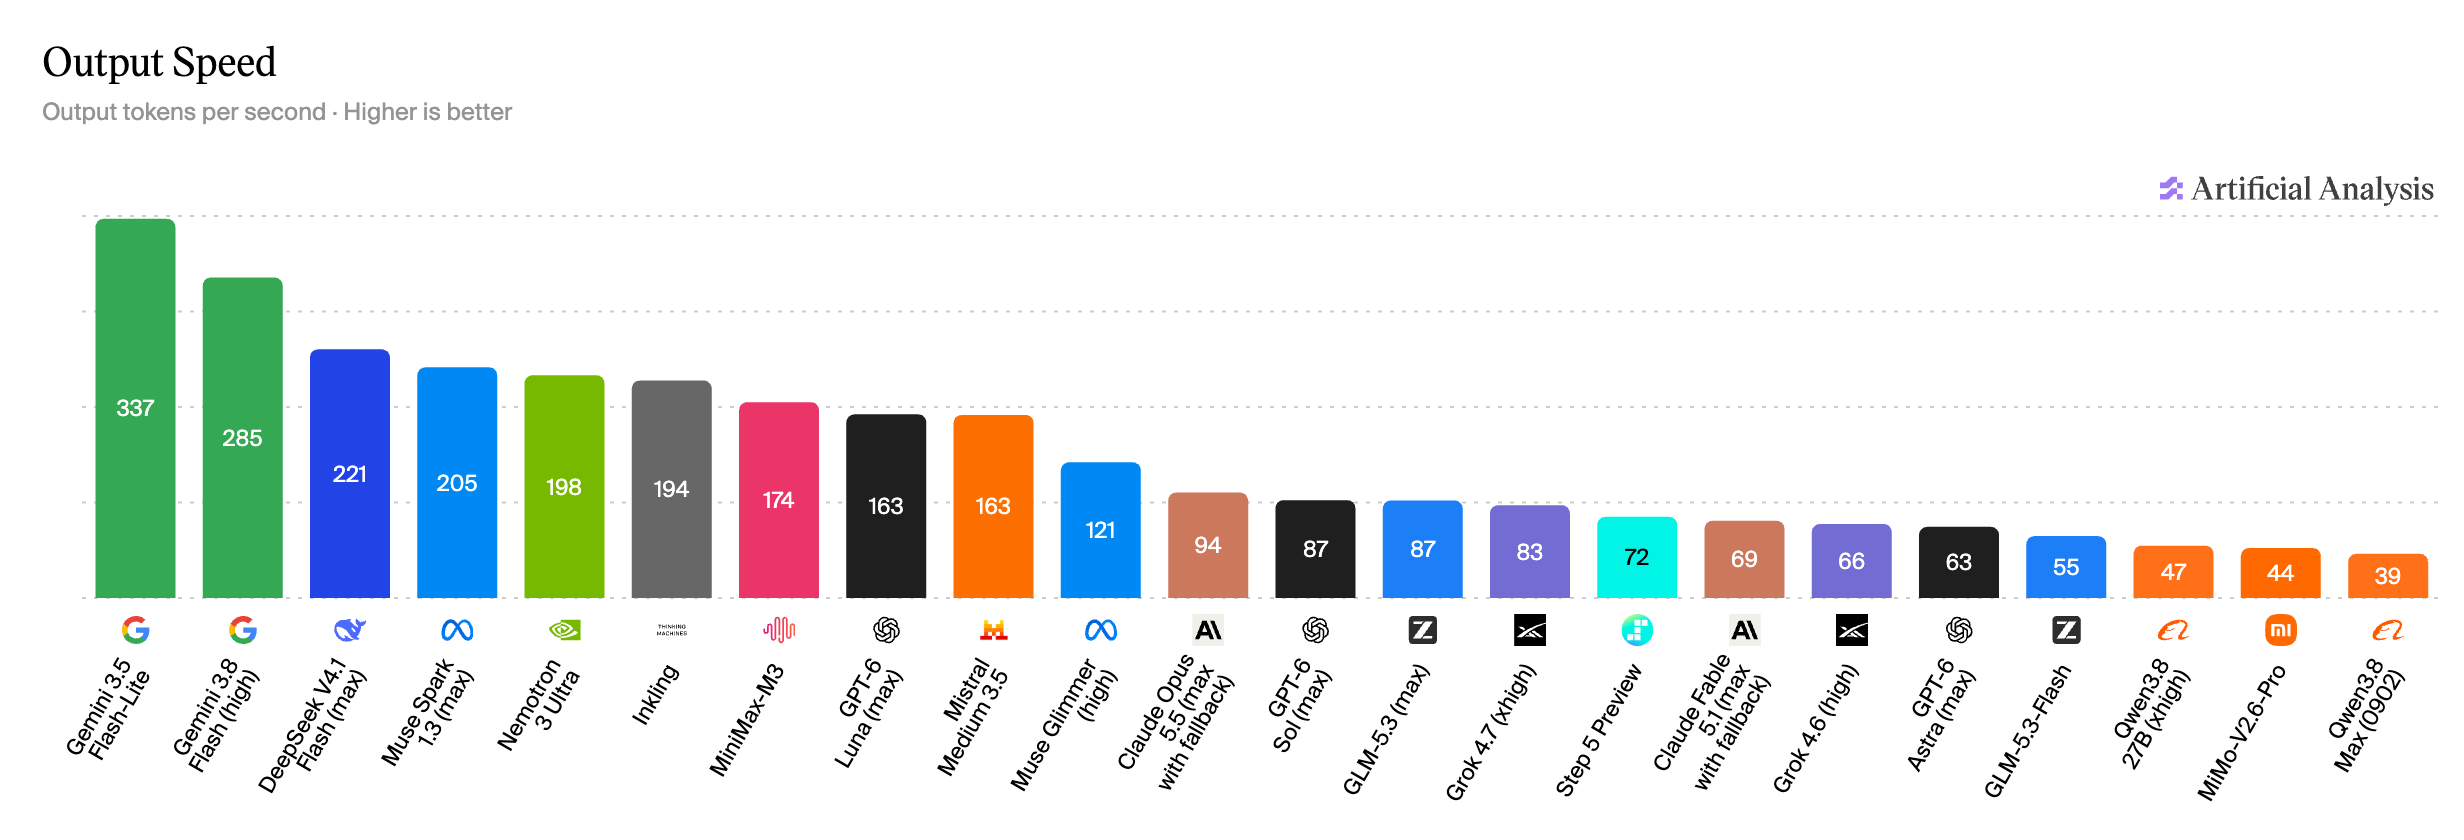
Tốc độ đầu ra
So sánh tốc độ văn bản xuất hiện sau khi bắt đầu tạo.
Diễn giải biểu đồ
Trong nhóm này, Gemini 3.5 Flash-Lite đạt 337 token/giây và Gemini 3.8 Flash ở mức high đạt 285 token/giây. Đầu ra nhanh hỗ trợ truyền câu trả lời dài.
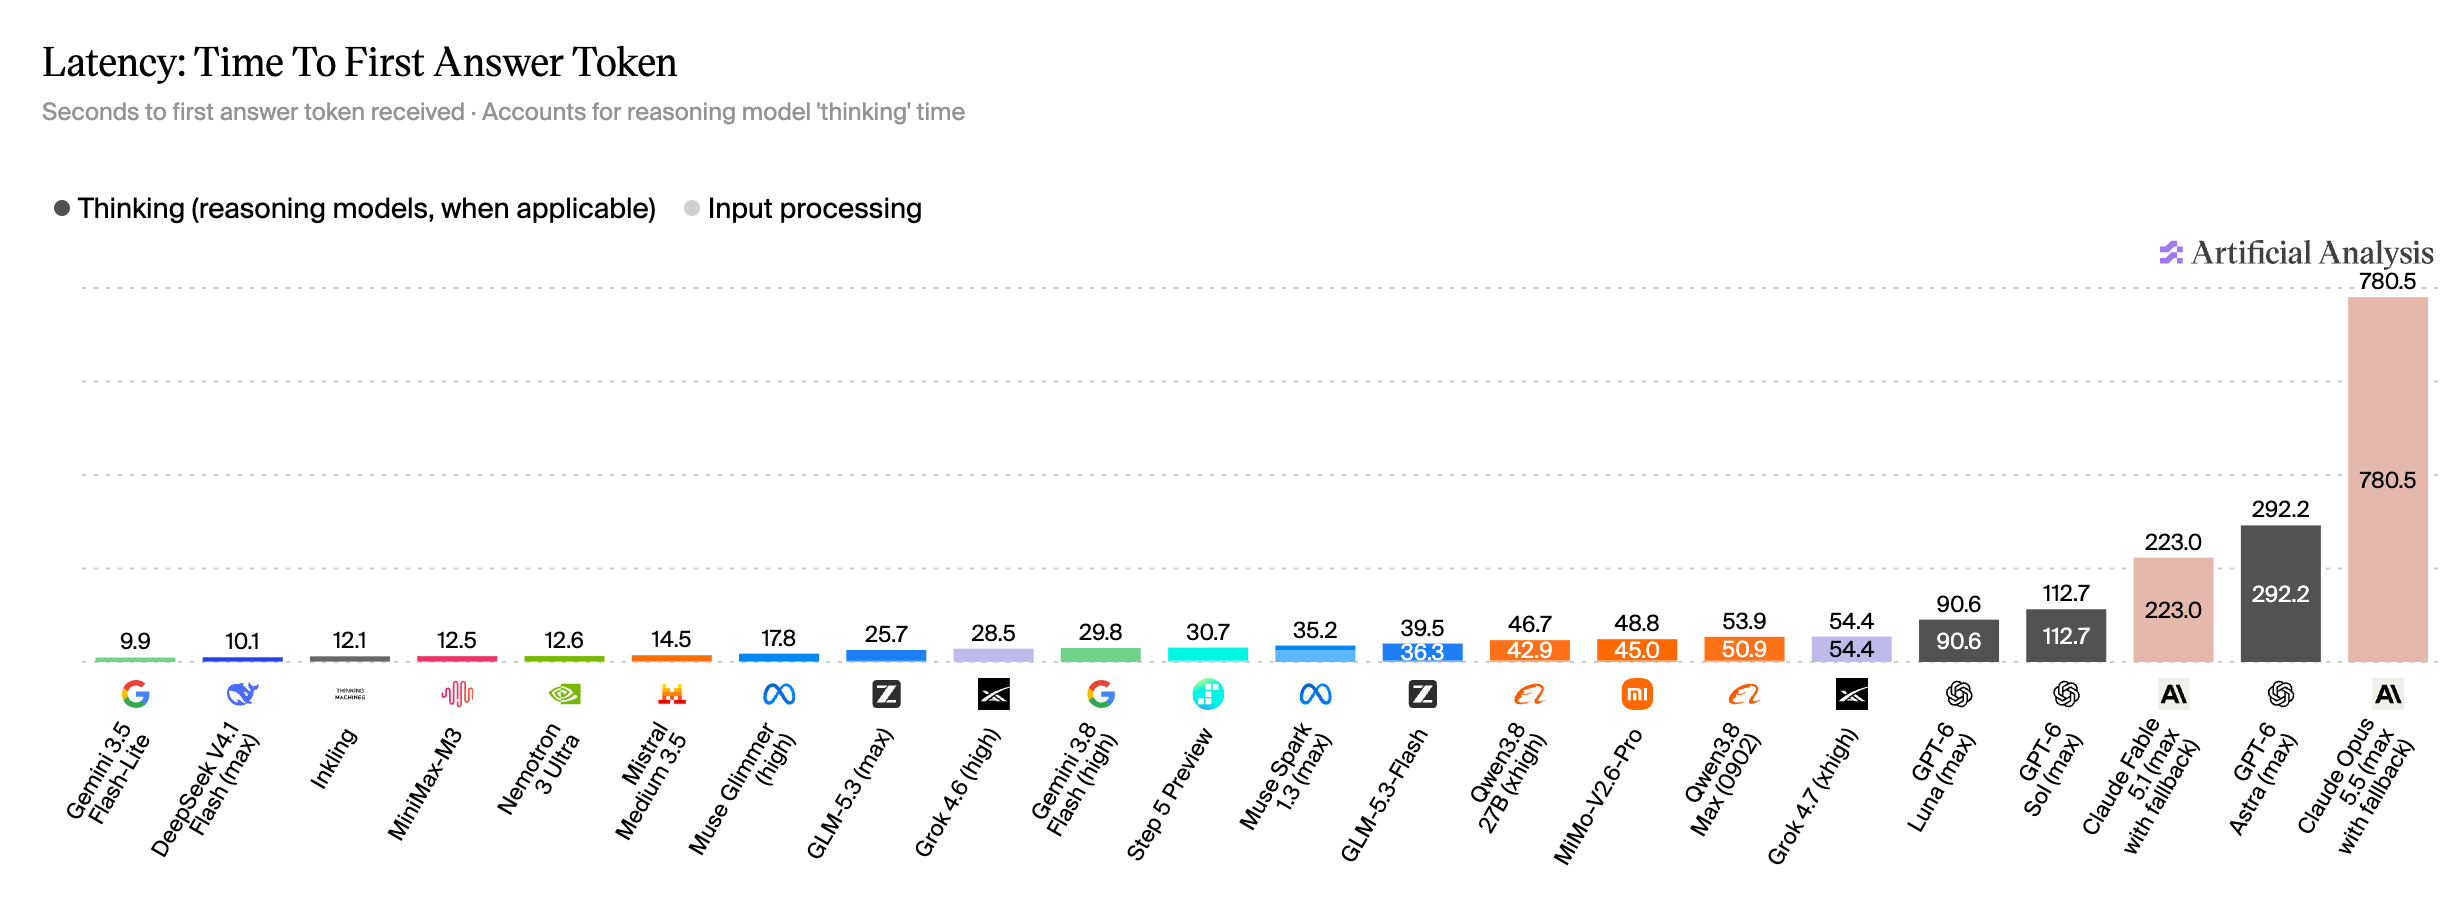
Thời gian đến câu trả lời đầu tiên
Đo thời gian chờ trước khi người dùng nhận token trả lời đầu tiên.
Diễn giải biểu đồ
Grok 4.7 ở mức xhigh hiển thị 54,4 giây, còn GPT-6 Astra ở mức max là 292,2 giây. Thời gian suy nghĩ có thể chiếm phần lớn thời gian chờ.